如果要做一台會思考的機器
ReinforcementLearning
如果要做一台 會思考的機器,你會怎麼做?
現在的機器是怎麼思考的?
思考甚麼?
- 思考「墮胎是否該合法化」
- 思考 圍棋下一步該怎麼走?
- 思考 德州撲克 這一步該 call 還是 fold? 或是 raise?
- 思考 「看一張圖片,用文字表達出來」
- 思考 在平面上 n 個點,最多可以有多少點對的距離恰好是1?是 O(n) 嗎?
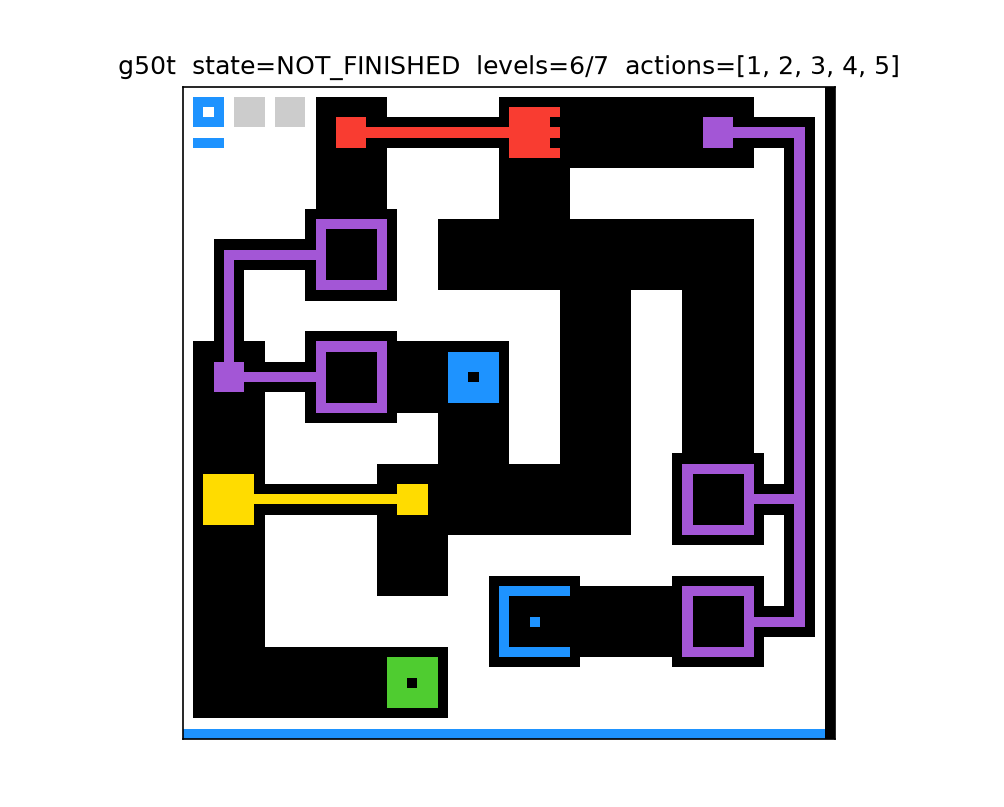
- 思考 在一個 64*64 的像素小遊戲中,沒告訴你如何獲勝,你可以按上下左右、空白鍵、或是用滑鼠點選其中一個像素,就這樣。你該如何「獲勝」?
目前為止 最會思考的機器
直到 2026年8月11日,AI已經解掉以上所有挑戰--除了最後一項。
只能玩一次
老實說,最後一項某種程度也是解掉了,就看你怎麼計分。
如果這個遊戲作為一個黑盒子給你,給你玩 上萬場,AI 是可以學會的。但在我們計分標準下這分數趨近於零。
我們計算: \min\big(\big(\frac{\text{普通人第一次玩所用的步數中位數}}{\text{agent 一次玩的步數}} \big)^2, 1.15\big) * 100
所以說,失敗重玩,胡亂探索,胡亂點沒用用的格子… ,這些都算步數。
如果給機器夠長的時間(比方說6400 CPU hours) 他可以學會玩一個遊戲。這完全做得到,這也是 2017年 Atari 被 deep Q-learning 破解的故事。57種遊戲有40種玩得比人類專家還高分。但他們用了很長時間,餵給機器 ~ 20 million frame畫面,才學會一個遊戲。
POV: 機器看到甚麼
從機器的視角,他看到的 64*64的像素畫面 就是一個2d array: A[64][64]。相鄰就有相關這件事情對人類是直覺,對機器來說卻一點不顯然。我們按下”上” 會自然期待一個操作是跟”向上”這個概念是有關的。“空白鍵” 就跟方向無關,他是一個state切換、一個switch之類的。地圖上很多”色塊”,有些色塊一眼就知道是邊界,純粹做區隔使用。有些色塊是地板,有些是主角(可能顏色跟其他所有都不一樣的那個) 有些一看就知道 沒有主角,是拼圖遊戲,之類的。人類很快可以發現這些事情,找出背後規則。
所以說 思考一下你的模型,
- 你的模型知道 A[64][64] 打亂之後 其實就變超難嗎?
- 你的模型知道 一個action 對應一個”功能” 是有規則的嗎?(world model) 他有辦法輕易generalize沒看過的state嗎??
- 你的模型有沒有辦法知道,同樣在64*64,遊戲的不同區塊其實可以表達不同含意? 有些區塊可能提供了答案的形狀。有些區塊是地圖區、有些區塊是 功能區。
- 你的模型知道 罕見的顏色 (很可能)代表比較重要嗎?
- 你的模型知道 「完形」的概念嗎? 比方說 把兩個”形狀一樣” 的東西 疊在一起 很可能就會過關? 把東西拼起來、或是兩個看起來像街頭的東西接上 也很可能就會過關??
- 你的模型知道 畫面有動 應該都有”原因” 嗎? 也就是一定跟你的操作有關,畫面不會無緣無故的變化,一定有個邏輯在背後。(如果背景在下雪 模型很可能就崩了)
- 你的模型知道 transition 完全沒有隨機性嗎? 沒有會攻擊你的對手,是你單方面要去解一個任務。
也不盡然很簡單
這個 Montezuma’s Revenge遊戲,就很難,至少在第一波 DQN 解掉 Atari時,他是墊底的,遠遠比人類玩得不好。
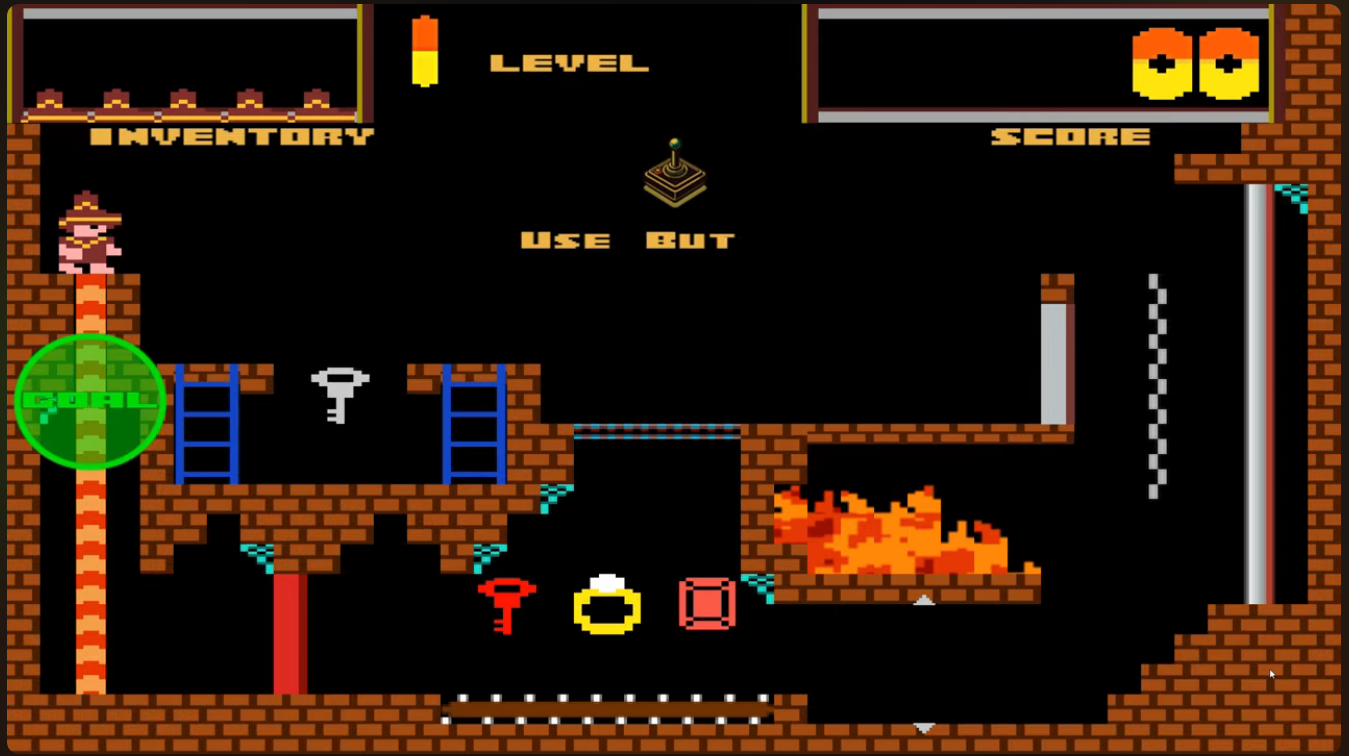
其實還挺難的